生成AIを社内に置いて使う「オフライン生成AI(ローカルLLM)」の費用は、調べると数百万円から数千万円まで幅があります。
幅だけ見ても、自社の金額は分かりません。
この記事では、オフラインで生成AIを使うのに何が必要で、費用はどう決まるのかを、弊社が実際にご案内している構成をもとに「初期費用」「保守」「継続費」の3区分で整理します。
金額はすべて2026年10月時点の目安です。GPUの価格は在庫・為替で短期間に動くため、「この水準で動く」ではなく「この順番で高くなる」と読んでください。
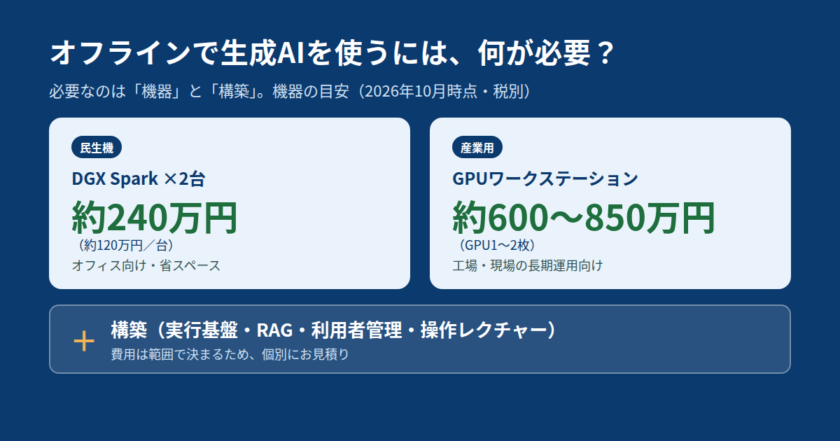
オフラインで生成AIを使うのに必要なのは、機器と構築。機器は民生機のDGX Spark 2台で約240万円、産業用GPUワークステーションで約600〜850万円。構築費は範囲で決まるため個別見積。人数の上限は「同時に送る数」と「入力の長さ」で決まります。さらに費用を抑えたい場合は、耐久性・買い替え・PoC前提の注意つきで民生用PC(GeForce RTX)も検討対象。金額は2026年10月時点の目安で、GPU価格は変動します。
目次(9項目)
結論:必要なのは機器と構築。機器は民生機で約240万円、産業用で約600〜850万円
| 構成 | 向いている環境 | 機器の目安 |
|---|---|---|
| 民生機|DGX Spark ×2台 | オフィス。日常的に使う人で〜10名/台が安全側の目安(20名で2台) | 約240万円(約120万円/台) |
| 産業用|GPUワークステーション | 工場・現場。日常的に使う人で〜20名/1台が安全側の目安 | 約600万円(GPU1枚)/約850万円(GPU2枚) |
| (参考)民生用PC|GeForce RTX搭載 | さらに費用を抑えたい場合・PoC用途 | PC一式 約50〜170万円(GPUで変動・下記の注意点あり) |
いずれも税別・買い切りで、月額のライセンス費用はありません。
構築費は機器とは別にかかります。取り込む文書の量、RAGの範囲、利用者管理の作り込みで変わるため、個別にお見積りします。
- 人数の目安は弊社の安全側の値で、登録する人数に上限はありません。決まるのは同時に送る質問の数で、上限を超えても止まらず、回答が出始めるまでの時間が延びます(詳しくは1章末尾)。
- 20名以下なら、どちらの構成でも対応できます。
- 主な分かれ目は置く場所です。オフィスなら民生機、工場や現場で長期運用するなら産業用です。
- 弊社の基本は上の2構成です。さらに費用を抑えたい場合は、注意点つきで民生用PCも検討できます(1章末尾)。
1. 初期費用=機器+構築
機器が金額差のほぼすべてです。
- 民生機(DGX Spark): 150×150×50.5mm・1.2kgの小型AI専用機(メモリ128GB版)。台数を足して人数を広げます。
- 産業用GPUワークステーション: 高性能GPU(例:NVIDIA RTX PRO 6000・96GB)を搭載。GPU増設で性能を広げます。20名以下ならGPU1枚で足りる場合があります。
構築は、どの構成でも標準の範囲は同じです。金額は範囲によって変わるため、個別にお見積りします。
- 基盤環境のセットアップ(複数台なら利用の振り分け設定)
- LLM実行基盤とAIモデルの導入
- ローカルAIエージェント基盤の構築
- PDFを取り込んだナレッジ検索(RAG:社内文書を探して根拠つきで答える仕組み)
- モデル切り替え・設定調整ができる状態での引き渡し
- 操作レクチャー・初期活用支援
- 利用者管理(ID・パスワード、部署別に使えるAI・文書の範囲を制限)
含まれないのは、個別業務向けの開発(個人情報の自動マスクなど)、標準を超える権限管理、外部システム連携です。別途お見積りになります。
何人まで使えるかは「同時に送る数」と「入力の長さ」で決まります
回答が10秒以内に出始めることを目安にすると、DGX Spark 1台で同時に送れるのは、短い質問なら20件前後、資料を参照する質問なら5〜10件、長い文書の要約なら1〜2件です(公開ベンチマーク・gpt-oss-120b・vLLM からの弊社試算)。産業用GPUワークステーションはそれぞれ2〜4倍程度が目安です。
全員が同じ瞬間に送ることはまれなので、日常的に使う人はこれより多くても対応できます。長文の要約を多く使う場合や、2秒以内の応答開始を求める場合は、同時に送れる数が大きく減ります。モデルと入力の長さで変わるため、実際の文書で確かめてから台数を決めます。
(参考)さらに費用を抑えたい場合:民生用PC+GeForce RTX
弊社がご案内する基本はDGX Sparkまたは産業用です。「それでも初期費用を下げたい」「まず自社の文書で試したい」という場合に限り、市販PCにGeForce RTXを載せた構成も検討対象になります。
| GPU(2026年10月・価格.com等の実売) | VRAM | 公式値で載るモデルの例 |
|---|---|---|
| RTX 5070(約15〜19万円) | 12GB GDDR7 | Gemma 4 12B(4bit)、Qwen3 8B/14B(INT4) |
| RTX 5070 Ti/5080(約21〜32万円) | 16GB GDDR7 | 上記+gpt-oss-20b(公式の最低ライン16GB) |
| RTX 5090(約115万円〜・流通少) | 32GB GDDR7 | 上記+Gemma 4 31B(4bit)、Qwen3 32B(INT4) |
PC一式(メモリ64GB)はBTOで、RTX 5070搭載機が約50万円、RTX 5090搭載機が約140〜170万円です(2026年10月のBTO各社の表示価格から)。
民生用PCを選ぶ前の注意点
- 耐久性: 一般向けの部品で、24時間稼働や工場環境を前提にしていません。産業用のような長期の安定稼働は見込めません。
- 買い替え前提: 数年で機器を入れ替える前提で考えてください。本番に移す際はSparkか産業用へ載せ替えが必要になります。
- PoC前提: 載せられるモデルはSpark(128GB)より小さく、同時利用も少人数向けです。「効果を確かめる段階」の構成とお考えください。
2. 保守=選択制の月額
保守はご希望の場合のみ、月額でご契約いただきます(金額は別途お見積り)。
- 範囲: 障害対応(訪問含む)・AIモデル更新・OS更新・ソフト更新・RAGの文書追加と精度調整・問い合わせ窓口
- 付けない場合: 月額ゼロ。更新・バックアップ・文書追加はお客様側、不具合は都度お見積り
生成AIは半年で構成が古くなることも珍しくありません。長く使うなら、保守の有無は導入時に決めておくのがおすすめです。
3. 継続費=電気代程度
モデル利用料・ライセンス料・サーバー管理費はかかりません。
残るのは電気代で、DGX Spark 2台の常時稼働で月1万円程度です(240W×2台・30円/kWhの弊社試算)。産業用はこれより高くなります。
「月額ゼロ」はベンダーへの支払いの話です。更新・故障対応・将来の機器更新の手間は残ります。
見積の幅は、この4つで決まります
- 置く場所と規模: オフィスで〜20名なら民生機、現場なら産業用
- モデル・機器のグレード: 動かすモデルのサイズで必要なGPUが決まる
- RAG構築の範囲: 標準の取り込みまでか、業務ごとの個別開発まで含むか
- 伴走支援の有無: 納品して終わりか、操作レクチャー・定着支援まで含むか
人数・置く場所・作り込みの範囲を先に決めてから見積を取ると、適正額に早くたどり着きます。
クラウド型との使い分けは「オフライン生成AIとクラウド、どちらを選ぶべきか」で整理しています。
内製すると安いのか
専任チームを組むと、人件費だけで年間約3,840万円になります(AIエンジニア月100万円+ITエンジニア月70万円+インフラ月70万円+PM月80万円の12か月・当社調べの目安)。機器は内製でも同程度かかります。
内製が向くのは、AI基盤を自社で育て続ける人材を持つ場合です。「一度作って安定して使いたい」なら、構築を外部に任せる選択肢があります。比べるときは、保守を含めた年額で揃えてください。
投資対効果:何名で、何分減るか
弊社のモデルケース(従業員100名・平均年収500万円)では、1人1日7分の削減で年間約750万円の効果になります。
7分 × 100名 × 年240日 = 約2,800時間 ≒ 約750万円/年
- 100名規模なら人数に応じて台数を決めます。産業用の機器2台分(約1,200万円〜)と比べても、機器費用だけならおおむね2年以内に見合う計算です。
- 20名なら削減額は年間約150万円です。民生機2台(機器約240万円)なら2年弱です。
いずれも構築費・保守費・電気代は含まず、効果を保証するものではありません。自社の人数と数字で試算し直してください。
小さく始めて広げる(金額は変動する前提で)
1|DGX Spark 1台で始める
機器は約120万円が目安です(構築費は範囲により別途)。費用を抑えるなら、注意点を踏まえたうえで民生用PCのPoCから入る方法もあります。実際の社内文書で、どの業務が何分減るかを確かめます。
2|台数追加、または産業用へ
Sparkを足すか、GPUワークステーションを追加します。1台目は特定チーム用・検証用として使い続ける想定です。文書の引き継ぎ方は拡張時の構成に合わせてご案内します。
利用開始までの目安は、民生機で2〜3か月、産業用で3〜5か月です(機器納期+構築1〜2か月)。
まとめ:見積を取る前に決める3つ・各社に聞く4つ
先に決めること
- 何人が使い、どこに置くか(オフィスか、工場・現場か)
- どの社内文書を読ませるか
- 運用を自社でやるか、保守を任せるか
各社に聞くこと
- 構築にどこまで含まれるか(上の7項目と突き合わせる)
- 保守は必須か、選択制か
- 保守の月額と、保守なしの場合の対応
- 機器の納期と、利用開始までの期間
構成別の概算をお出しします
「自社の人数・置く場所だと、どの構成になるのか」。そうしたご相談に、構成別の概算をお出しします。売り込みはいたしません。金額感だけ持ち帰っていただく形でも構いません。
社外に出る通信・出ない通信の確かめ方は「オフライン生成AIで外に出る通信・出ない通信」をご覧ください。
参考(仕様・価格・ベンチマーク・体感閾値の確認元)
- Dendro Logic「NVIDIA DGX Spark concurrency benchmark」(2026-04-22・gpt-oss-120b・同時8件で1件あたり15.4トークン/秒。1トークン≒1〜1.5文字で換算): https://dendro-logic.com/engineering/nvidia-dgx-spark-concurrency-benchmark/
- NVIDIA DGX Spark 製品ページ: https://www.nvidia.com/en-us/products/workstations/dgx-spark/
- NVIDIA RTX PRO 6000 製品ページ: https://www.nvidia.com/en-us/products/workstations/professional-desktop-gpus/rtx-pro-6000/
- NVIDIA GeForce 比較表(RTX 5090/5080/5070 Ti/5070 の VRAM・GDDR7・帯域・消費電力): https://www.nvidia.com/en-us/geforce/graphics-cards/compare/
- 価格.com GeForce RTX 5070 12G VENTUS 2X OC(最安価格の確認元・2026-10-19): https://kakaku.com/item/K0001679747/
- 価格.com GeForce RTX 5090(最安価格の確認元・2026-10-19): https://kakaku.com/item/K0001674505/
- ドスパラ GALLERIA SMC9E-R59-GL(RTX 5090・64GB・基本構成価格の確認元): https://www.dospara.co.jp/TC30/MC20676.html
- ドスパラ GALLERIA FDR7A-R57-W(RTX 5070・64GB増設差額の確認元): https://www.dospara.co.jp/TC30/MC25861.html
- OpenAI gpt-oss-20b モデルカード(16GBで動作の記述): https://huggingface.co/openai/gpt-oss-20b
- Google Gemma 4 必要メモリ表: https://ai.google.dev/gemma/docs/core
- Qwen3 速度ベンチマーク(GPUメモリ使用量): https://qwen.readthedocs.io/en/latest/getting_started/speed_benchmark.html
- Nielsen Norman Group「Response Times: The 3 Important Limits」(0.1秒・1秒・10秒の体感閾値): https://www.nngroup.com/articles/response-times-3-important-limits/
- 小林・川嶋「日本語文章の読み速度の個人差をもたらす眼球運動」映像情報メディア学会誌 2018(黙読 平均653字/分): https://doi.org/10.3169/itej.72.J154